Stable Diffusion Nedir ve Nasıl Çalışır? Kapsamlı Rehber
Stable Diffusion, metin açıklamalarından yüksek kaliteli görseller üreten açık kaynaklı bir yapay zeka modelidir. Donanım gereksinimlerinden çalışma mantığına kadar tüm detayları bu rehberde bulabilirsiniz.
Mustafa Hazırcı yazılarını Google'da daha sık görmek için tercih edilen kaynak olarak ekleyin
Bu yazıda
Stable diffusion nedir sorusu, açık kaynak kodlu yapısıyla kullanıcıların kendi donanımlarında yüksek kaliteli görseller üretmesini sağlayan derin öğrenme tabanlı bir metinden görsele dönüşüm modelini ifade eder. Stability AI, CompVis grubu ve Runway iş birliğiyle geliştirilen teknoloji, metin komutlarını işleyerek sıfırdan görsel üretme, resim onarma ve tarz değiştirme yetenekleriyle öne çıkmaktadır.
Stable Diffusion Nasıl Çalışır ve Mimarisi Nasıldır?
Modelin temel yapısı, piksel alanındaki verileri doğrudan işlemek yerine daha küçük boyutlu örtük alanda (latent space) çalışan bir örtük difüzyon mimarisine dayanır. Yapı üç ana bileşenden oluşur: Variational Autoencoder (VAE), U-Net ağı ve metin kodlayıcı. VAE bileşeni, yüksek çözünürlüklü görselleri anlamsal özelliklerini koruyarak sıkıştırır. Bu sıkıştırılmış temsil üzerinde ileri difüzyon aşamasında kademeli olarak Gaussian gürültüsü uygulanır.
Gürültü temizleme sürecini yürüten U-Net mimarisi, ResNet altyapısını kullanarak örtük alandaki gürültüyü adım adım kaldırır ve orijinal anlamsal yapıyı yeniden inşa eder. Kullanıcının girdiği metin komutları ise önceden eğitilmiş CLIP ViT-L/14 metin kodlayıcısı aracılığıyla matematiksel vektörlere dönüştürülür. Çapraz dikkat (cross-attention) mekanizması, bu metin vektörlerini U-Net bileşenine besleyerek görselin kullanıcının tarif ettiği öğeler doğrultusunda şekillenmesini sağlar. İşlem sonunda VAE kod çözücüsü, örtük alandaki veriyi tekrar piksel alanına çevirerek final görseli oluşturur.
Mimari zaman içinde ciddi güncellemeler geçirmiştir. SDXL versiyonu daha büyük U-Net altyapısı, çift metin kodlayıcı ve farklı en-boy oranlarında doğrudan üretim yeteneği sunmuştur. Stable Diffusion 3.0 sürümünde ise U-Net yerine Rectified Flow Transformer mimarisine geçilmiştir. Bu Multimodal Diffusion Transformer (MMDiT) yapısı, metin ve görsel kodlamalarını aynı süreç içerisinde çift yönlü olarak işleyerek komutlara uyum yeteneğini artırmıştır. Gelişmiş donanım mimarileri üzerine inşa edilen bu teknikler, üretken yapay zeka çözümlerinin yerel bilgisayarlarda yüksek verimlilikle çalışmasına olanak tanımaktadır.
Stable Diffusion ile Görsel Oluşturma Yöntemleri
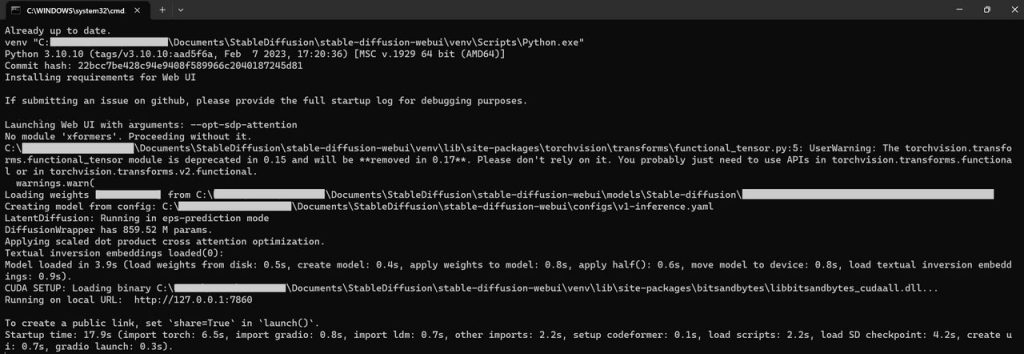
Sistem üzerinden görsel üretirken kullanılan temel yöntem metinden görsele (txt2img) oluşturma işlemidir. Bu süreçte yazılan metin komutunun yanı sıra rastgelelik derecesini belirleyen tohum (seed) değeri, örnekleme adımı sayısı ve yönlendirme ölçeği (CFG scale) gibi parametreler ayarlanır. Yönlendirme ölçeği yükseltildiğinde model yazılan komuta daha katı şekilde bağlı kalırken, düşük değerlerde modele daha fazla sanatsal serbestlik tanınır.
Bir diğer önemli yöntem ise görselden görsele (img2img) dönüştürme tekniğidir. SDEdit yaklaşımını kullanan bu yöntemde, mevcut bir görselin üzerine belirlenen oranda gürültü eklenir ve ardından metin komutu rehberliğinde yeniden gürültü temizleme yapılır. Görsel gücü parametresi (strength), orijinal resmin ne kadar değiştirileceğini kontrol eder. Ayrıca arayüzler üzerinden sunulan inpainting özelliği ile görselin sadece belirli bir alanı silinerek yeniden çizilebilir; outpainting özelliği sayesinde ise tuval sınırları dışına doğru görsel genişletilebilir.
Görsel üretiminde istenmeyen öğeleri engellemek için negatif komutlar (negative prompts) kullanılır. Örneğin bozuk parmaklar, bulanık arka planlar veya düşük çözünürlük gibi unsurlar negatif komut alanına yazılarak modelin bu özellikleri üretmesi engellenir. Söz konusu teknikler, başarılı bir yapay zeka ile görsel oluşturma süreci yönetmek isteyen pazarlamacılar ve grafik tasarımcılar için büyük esneklik sağlar.
Modeli Kişiselleştirme ve İnce Ayar Seçenekleri
Modelin standart eğitiminde bulunmayan özel nesneleri, karakterleri veya sanat tarzlarını sisteme öğretmek için kullanıcı seviyesinde ince ayar (fine-tuning) yöntemleri uygulanır. Standart ağırlıkları değiştirmeden yeni kavramlar eklemek için üç temel teknik öne çıkar:
- Embeddings (Textual Inversion): Kullanıcının sunduğu az sayıda görsel üzerinden metin kodlayıcıya yeni bir kelime vektörü tanımlanır. Modelin ana ağırlıkları değişmez, yalnızca küçük bir dosya oluşturularak istenen tarz veya nesne çağrılabilir.
- Hypernetworks: Ana sinir ağının kritik noktalarına bağlanan küçük katmanlardır. Görseldeki kilit alanları tespit ederek üretimi belirli bir sanatsal üsluba doğru yönlendirir.
- DreamBooth: Özel bir nesne veya kişiyi yüksek hassasiyetle modele öğretmek için kullanılan derin öğrenme yöntemidir. Az sayıda fotoğrafla modelin veri setine yeni bir özne tanımlanmasını sağlar.
Bu kişiselleştirme teknikleri sayesinde markalar kendi ürün kataloglarını veya kurumsal görsel dillerini modele entegre ederek özelleştirilmiş çıktılar elde edebilirler.
Eğitim Verileri, Donanım Gereksinimleri ve Sınırlılıklar
Stable Diffusion modelleri, internet üzerinden derlenen ve açık olarak paylaşılan LAION-5B veri setinin belirli alt kümeleri (laion2B-en, laion-high-resolution, laion-aesthetics v2 5+) ile eğitilmiştir. Eğitim süreci Amazon Web Services üzerinde 256 adet Nvidia A100 GPU kullanılarak toplam 150.000 GPU saati sürmüş ve yaklaşık 600.000 dolar maliyetle tamamlanmıştır. Veri setinin büyük ölçüde İngilizce tanımlardan oluşması, modelin Batı merkezli bir görsel eğilime sahip olmasına ve zaman zaman algoritmik yanlılıklara yol açabilmektedir.
Modelin en büyük avantajı, bulut sunucularına bağımlı kalmadan tüketici sınıfı donanımlarda çalışabilmesidir. Temel model 2.4 GB VRAM kapasitesine sahip bir ekran kartında çalışabilirken, akıcı bir üretim süreci için 10 GB veya üzeri VRAM önerilmektedir. Ayrıca hassasiyet modunun float32 yerine float16 olarak ayarlanması bellek kullanımını önemli ölçüde düşürür. OpenVINO sürümü sayesinde işlemler yalnızca işlemci (CPU) üzerinde de yürütülebilir.
| Sürüm / Yöntem | Varsayılan Çözünürlük | Öne Çıkan Mimari Farkı |
|---|---|---|
| Stable Diffusion 1.5 | 512×512 piksel | Klasik Latent Diffusion (U-Net + CLIP) |
| Stable Diffusion XL (SDXL) | 1024×1024 piksel | Çift Metin Kodlayıcı ve Refiner Modülü |
| Stable Diffusion 3.0 | Değişken Çözünürlük | Rectified Flow Transformer (MMDiT) |
Modelin ilk sürümlerinde insan uzuvlarının hatalı çizilmesi, karmaşık metin ve tipografi ifadelerinin bozulması gibi sınırlılıklar mevcuttu. SDXL ve SD 3.0 sürümleriyle birlikte bu anatomi ve metin oluşturma sorunlarında belirgin iyileşmeler sağlanmıştır. Süreç içerisinde etik veri kullanımı ve içerik doğruluğu gibi konular ön plana çıktığı için kurumsal uyum süreçlerinde yapay zeka etiği prensiplerini gözetmek büyük önem taşır.
İşletmeler ve Dijital Pazarlamada Kullanım Alanları
Açık kaynaklı yapay zeka modelleri, e-ticaret siteleri ve dijital pazarlama ajansları için stok fotoğraf maliyetlerini sıfırlama ve hızlı içerik üretme imkanı tanır. Ürünlerin farklı konseptlerdeki görsellerini hazırlamak, sosyal medya kampanyaları için özgün materyaller oluşturmak ve web sitesi banner tasarımlarını çeşitlendirmek bu teknolojiyle oldukça pratiktir.
E-ticaret yöneticileri, img2img ve inpainting tekniklerini kullanarak arka plan değiştirme veya ambalaj varyasyonları oluşturma işlemlerini dakikalar içinde tamamlayabilir. Donanımın yerel olarak çalıştırılması, şirket verilerinin ve henüz piyasaya sürülmemiş ürün tasarımlarının gizliliğini korumak açısından stratejik bir avantaj sunar. Otomatik görsel üretim hatlarının kurulması, makine öğrenmesi tabanlı araçların pazarlama operasyonlarına entegrasyonunu hızlandırmaktadır.
Sık sorulan sorular
Stable Diffusion tamamen ücretsiz mi?
Evet, Stable Diffusion açık kaynak kodlu ve ücretsiz bir modeldir. Kodları ve model ağırlıkları kamuya açık şekilde yayınlanmıştır. Kullanıcılar modeli kendi bilgisayarlarına indirip herhangi bir abonelik ücreti ödemeden yerel donanımlarıyla çalıştırabilirler.
Stable Diffusion çalıştırmak için nasıl bir bilgisayar gerekir?
Modelin çalışması için temel seviyede en az 2.4 GB VRAM kapasitesine sahip bir NVIDIA ekran kartı yeterlidir. Ancak hızlı ve yüksek çözünürlüklü görseller üretmek için 8 GB veya 10 GB üzeri VRAM sunan güncel bir GPU önerilir.
Stable Diffusion ile Midjourney arasındaki temel fark nedir?
Midjourney kapalı kaynaklı bir yazılım olup yalnızca kendi bulut sunucuları üzerinden ücretli abonelikle hizmet verir. Stable Diffusion ise açık kaynaklıdır, kendi bilgisayarınıza kurulabilir, tamamen özelleştirilebilir ve internet bağlantısı olmadan çalıştırılabilir.
Negative prompt (negatif komut) ne işe yarar?
Negatif komutlar, yapay zekanın ürettiği görselde yer almasını istemediğiniz özellikleri belirttiğiniz alandır. Bulanıklık, kötü çizilmiş eller, ekstra uzuvlar veya istenmeyen renkler bu alana yazılarak görsel kalitesi artırılır.
Bu içerik, Vikipedi kaynağındaki bilgilerden yararlanılarak editörümüzün yorum ve değerlendirmeleriyle hazırlanmıştır.